
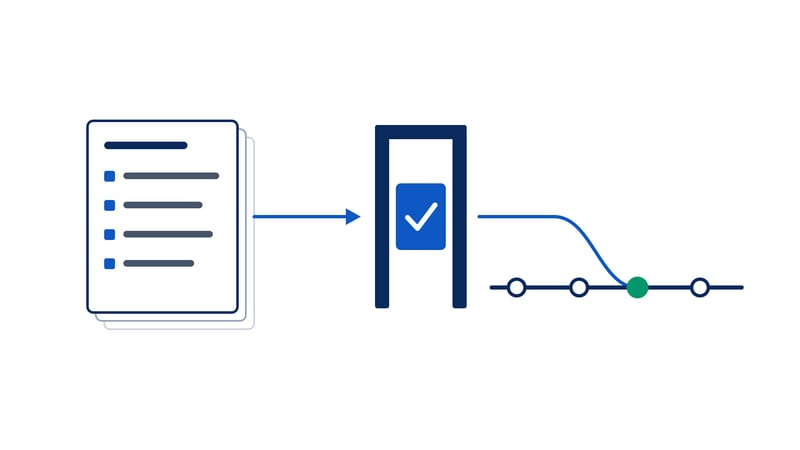
En su guía sobre evals para agentes, publicada en enero de 2026, el equipo de ingeniería de Anthropic escribe que definir las tareas de evaluación es una de las mejores formas de comprobar si los requisitos de un producto son lo bastante concretos para empezar a construir. Lo dice pensando en quien construye agentes. Vale igual para un equipo en el que los agentes escriben el código.
En Spec-Driven Development (SDD, desarrollo guiado por especificaciones), la especificación es la fuente de verdad y el código se deriva de ella. Pero en la práctica muchos equipos mantienen dos artefactos que no se hablan: la especificación, que se escribe al principio y se lee una vez, y los tests, que se escriben después, a menudo los genera el propio agente y a menudo salen del código, no de la especificación.
La tesis de esta pieza es que esos dos artefactos deberían ser uno. Si cada criterio de aceptación se redacta de forma que una máquina o una persona concreta pueda puntuarlo sin interpretar, la especificación ya es el eval: el conjunto de comprobaciones que decide si un cambio entra en la rama principal. Y el corolario incómodo: sin un criterio que se pueda puntuar, la especificación no está terminada, por bien escrita que esté.
Dos documentos que deberían ser uno
La idea no es nueva; lo nuevo es que ahora es barata. El documento de método de spec-kit, el kit de GitHub para SDD, lo resume en una línea: «los escenarios de aceptación se convierten en tests». Y añade que los escenarios de prueba no se escriben después del código, sino que forman parte de la especificación de la que salen tanto la implementación como los tests.
Que eso pase de verdad depende de cómo esté escrito el criterio. La guía de Anthropic define una tarea de evaluación como una prueba con entradas definidas y criterios de éxito, y un evaluador como la lógica que puntúa algún aspecto del resultado. Un criterio de aceptación con entradas concretas y un resultado esperado ya es una tarea de evaluación. Lo que le falta para ser un eval es el evaluador: quién o qué dice «cumple» o «no cumple».
Cuando ese evaluador no sale del criterio, sale del código. Y un test escrito a partir del código no lo prueba, lo describe: confirma lo que el código hace, incluido lo que hace mal. Lo explicamos en detalle en tests generados por IA. La especificación como eval es la otra cara de ese problema: el criterio existe antes que el código y es lo único que puede juzgarlo.
La prueba de los dos lectores
¿Cómo se sabe si un criterio se puede puntuar? La guía de Anthropic da una vara sencilla para una buena tarea de evaluación: dos expertos del dominio llegarían por separado al mismo veredicto de aprobado o suspenso. Y avisa de lo que pasa si no: la ambigüedad en la especificación de la tarea se convierte en ruido en las métricas.
La prueba de los dos lectores: si dos personas que conocen el producto pueden leer un criterio, mirar el resultado y discrepar sobre si se cumple, ese criterio todavía no es un criterio. Es una intención.
La documentación de Anthropic sobre criterios de éxito insiste en lo mismo con otras palabras: específicos y medibles. Su ejemplo de criterio malo es «el modelo debe clasificar bien»; el bueno fija la métrica, el umbral y el conjunto de datos contra el que se mide. En un equipo de desarrollo, la traducción es directa. Estos son ejemplos inventados para ilustrarlo, no de un proyecto real:
| Criterio que no se puede puntuar | El mismo criterio, listo para ser un eval |
|---|---|
| «La exportación de facturas debe ser rápida» | Dado un fichero de 10.000 facturas, cuando se exporta en el entorno de integración continua, entonces la exportación termina en menos de 5 segundos |
| «Los errores deben ser claros» | Dada una factura sin NIF, cuando se envía a la API, entonces responde 422 y el campo nif aparece en la lista de errores |
| «Debe respetar los permisos» | Dado un usuario sin el rol de facturación, cuando pide la exportación, entonces recibe 403 y no se genera ningún fichero |
Ejemplos ilustrativos, elaboración propia de onext. El formato «dado, cuando, entonces» es el GIVEN/WHEN/THEN de BDD
El formato de la columna derecha no es casual. Birgitta Böckeler, de Thoughtworks, al analizar las herramientas de SDD, describe cómo una de ellas, Kiro, estructura los requisitos como historias de usuario con criterios de aceptación en formato GIVEN… WHEN… THEN…. Ese formato obliga a decir la entrada, la acción y el resultado, que es justo lo que necesita un evaluador.
Tres tipos de criterio, tres evaluadores
No todo criterio se puntúa igual, y forzarlo todo a un test automático es el error contrario al de no tener ninguno. La guía de Anthropic enumera las virtudes de los evaluadores basados en código —rápidos, baratos, objetivos, reproducibles— y también sus límites: son frágiles ante variaciones válidas que no encajan exactamente con lo esperado y les falta matiz. Para lo que tiene matiz propone modelos como jueces, calibrados con frecuencia contra el juicio de expertos humanos. Llevado a una especificación:
| Tipo de criterio | Quién lo puntúa | Qué hace en el merge |
|---|---|---|
| Determinista | Código: un test unitario, de integración o de contrato que sale del criterio | Frena. Si no pasa, el cambio no entra |
| Con matiz | Una rúbrica escrita en la especificación; si la puntúa un modelo, calibrado antes contra personas | Informa. Solo frena cuando el juez está calibrado y el umbral acordado |
| De riesgo o de negocio | Una persona con nombre, fijada en la especificación | Firma. Sin su firma, no entra |
Elaboración propia de onext, a partir de la clasificación de evaluadores de Anthropic (código, modelo y persona)
La tercera fila es la que más se olvida. Hay criterios que ningún evaluador automático debería decidir: los que tocan dinero, datos personales, permisos o una regla de negocio discutible. Ahí el eval es una persona, y la especificación tiene que decir cuál. Es la idea que desarrollamos en la especificación es donde se firma: no se firma todo, porque aprobarlo todo no es control, es un atasco; se firma donde hay riesgo.
La segunda fila tiene su propio método. Una rúbrica sin un conjunto de casos de referencia es una opinión con formato de métrica; cómo construir ese conjunto y qué significa «funciona mejor» lo tratamos en el golden set y en rúbrica y baseline.
La puerta del merge: lo nuevo falla primero y lo anterior sigue pasando
Con los criterios clasificados, la puerta del merge se monta con dos reglas, y ninguna es nuestra.
Lo nuevo falla primero. El método de spec-kit exige TDD estricto: no se escribe código de implementación hasta que los tests están escritos, los ha aprobado una persona y se ha confirmado que fallan. Un test que pasa antes de que exista el código no está comprobando nada. Aplicado a la especificación como eval: los tests que salen de los criterios nuevos se escriben antes que el código —los puede redactar un agente—, una persona los revisa contra el criterio, no contra la implementación, y tienen que fallar en rojo antes de empezar.
Lo anterior sigue pasando. Los criterios de las especificaciones ya integradas forman la suite de regresión. La guía de Anthropic dice que una suite de regresión debería rondar el 100 % de aciertos, y que los evals de capacidad que ya se superan con holgura pueden «graduarse» a regresión. Según la misma guía, es la estructura con la que se puntúa a los agentes de código en SWE-bench Verified: una solución solo pasa si arregla los tests que fallaban sin romper los que ya existían.
Con eso, revisar un pull request cambia de pregunta. Ya no es «¿me convence este código?», que con un agente que produce más cambios por hora se convierte en el cuello de botella, sino «¿los criterios de la especificación están cubiertos y en verde, y han firmado quienes tenían que firmar?». La revisión humana no desaparece; se concentra donde aporta. Lo desarrollamos en el review que sigue esperando a un autor.
Lo que esto no resuelve
Conviene decir los límites con la misma claridad que la tesis. El primero lo señala Böckeler: incluso con todos los ficheros, plantillas, flujos y listas de comprobación de las herramientas de SDD, vio con frecuencia que el agente acababa sin seguir todas las instrucciones. Una especificación más larga no garantiza que se cumpla. Precisamente por eso el control no está en la extensión de la especificación, sino en que cada criterio se compruebe antes de integrar.
El segundo límite es el reverso del primero: un eval solo aprueba lo que mide. Lo que la especificación no recoge, ningún test lo va a cazar, y un panel en verde puede dar la misma falsa sensación de control que Böckeler plantea para las propias herramientas de SDD. La prueba de los dos lectores ayuda a que cada criterio esté bien escrito; no dice si faltan criterios. Eso sigue siendo trabajo de quien conoce el producto.
Y el tercero es de coste: escribir criterios que se puedan puntuar lleva más tiempo al principio que escribir intenciones. No tenemos una cifra medida de cuánto, y no vamos a inventarla. Lo que sí se puede razonar es dónde se paga si no se hace: en un review que discute qué quería decir la especificación cuando el código ya está escrito.
Si quieres saber por dónde empieza esto en tu equipo, elige la última especificación que disteis por buena y recorre sus criterios uno a uno con una sola pregunta: quién o qué lo puntúa. Los que tengan respuesta ya son tu eval. Los que no, son el trabajo pendiente, y suelen ser los mismos que provocan las discusiones más largas en el review. Encaja en la perspectiva de procesos de las cuatro perspectivas de un equipo de desarrollo con IA: el ready es la especificación y el done, la verificación contra ella. Y si el método entero te resulta nuevo, empieza por qué es Spec-Driven Development.
La pregunta para tu próxima reunión de equipo: ¿cuántos criterios de vuestra última especificación podría puntuar alguien que no la escribió?
Preguntas frecuentes
¿Qué significa que una especificación sea un eval?
Que cada criterio de aceptación de la especificación está escrito con entradas concretas y un resultado que se puede puntuar, de modo que de él sale directamente la comprobación que decide si un cambio entra. La especificación deja de ser documentación que se lee antes de programar y pasa a ser lo que se ejecuta antes de integrar.
¿Cómo sé si un criterio de aceptación es verificable?
Con la prueba de los dos lectores: si dos personas que conocen el producto pueden leer el criterio, mirar el resultado y llegar por separado a veredictos distintos, el criterio no está terminado. La guía de evals de Anthropic usa esa misma vara para una buena tarea de evaluación y advierte de que la ambigüedad en la especificación se convierte en ruido en las métricas.
¿Todos los criterios de aceptación tienen que convertirse en tests automáticos?
No. Los criterios deterministas se comprueban con código y pueden frenar el merge. Los que tienen matiz, como la claridad de un mensaje, se puntúan con una rúbrica y, si se usa un modelo como juez, calibrado contra personas. Y los que dependen de un juicio de negocio o tienen riesgo los firma una persona con nombre. Forzarlo todo a test produce tests frágiles que fallan ante variaciones válidas.
¿Quién debe escribir el test que sale de un criterio de aceptación?
Puede escribirlo un agente, pero antes que el código y a partir del criterio, nunca a partir del código ya generado. Una persona revisa ese test contra el criterio, no contra la implementación. Un test derivado del código solo describe lo que el código hace, incluido lo que hace mal.
¿Qué evals deberían frenar un merge?
Dos grupos. Los criterios nuevos de la especificación, que tienen que fallar antes de implementar y pasar después. Y los criterios de especificaciones anteriores, que forman la suite de regresión: según la guía de evals de Anthropic, una suite de regresión debería rondar el 100 % de aciertos. Es la misma estructura con la que SWE-bench Verified da por buena una solución.
¿Basta con escribir una especificación más detallada para que el agente la cumpla?
No. Birgitta Böckeler, de Thoughtworks, cuenta que incluso con plantillas, listas de comprobación y flujos completos vio con frecuencia que el agente acababa sin seguir todas las instrucciones. Más especificación no garantiza el cumplimiento; lo que da control es que cada criterio se compruebe antes de integrar.
Fuentes
- Mikaela Grace, Jeremy Hadfield, Rodrigo Olivares y Jiri De Jonghe (Anthropic), «Demystifying evals for AI agents», 9 de enero de 2026.
- Anthropic, documentación de Claude, «Define success criteria and build evaluations».
- GitHub, spec-kit, «Specification-Driven Development (SDD)».
- Birgitta Böckeler (Thoughtworks), «Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl», martinfowler.com, 15 de octubre de 2025.
Bernat López es fundador y CEO de onext, boutique de IA. Acompaña a equipos de desarrollo y de producto a trabajar con IA con método —especificación antes de programar, una persona que decide donde hay riesgo y Spec-Driven Development— y aplica a su propia empresa lo que propone: onext funciona con su propio sistema agéntico.
LinkedIn →