
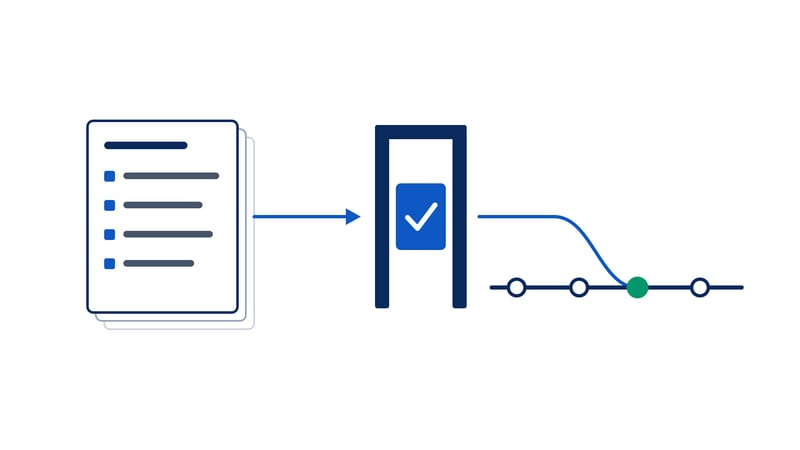
A la seva guia sobre evals per a agents, publicada el gener del 2026, l'equip d'enginyeria d'Anthropic escriu que definir les tasques d'avaluació és una de les millors maneres de comprovar si els requisits d'un producte són prou concrets per començar a construir. Ho diu pensant en qui construeix agents. Val igual per a un equip en què els agents escriuen el codi.
En el Spec-Driven Development (SDD, desenvolupament guiat per especificacions), l'especificació és la font de veritat i el codi se'n deriva. Però a la pràctica molts equips mantenen dos artefactes que no es parlen: l'especificació, que s'escriu al principi i es llegeix una vegada, i els tests, que s'escriuen després, sovint els genera el mateix agent i sovint surten del codi, no de l'especificació.
La tesi d'aquesta peça és que aquests dos artefactes haurien de ser un de sol. Si cada criteri d'acceptació es redacta de manera que una màquina o una persona concreta el pugui puntuar sense interpretar, l'especificació ja és l'eval: el conjunt de comprovacions que decideix si un canvi entra a la branca principal. I el corol·lari incòmode: sense un criteri que es pugui puntuar, l'especificació no està acabada, per ben escrita que estigui.
Dos documents que haurien de ser un de sol
La idea no és nova; el que és nou és que ara és barata. El document de mètode de spec-kit, el kit de GitHub per a l'SDD, ho resumeix en una línia: «els escenaris d'acceptació es converteixen en tests». I afegeix que els escenaris de prova no s'escriuen després del codi, sinó que formen part de l'especificació de la qual surten tant la implementació com els tests.
Que això passi de debò depèn de com estigui escrit el criteri. La guia d'Anthropic defineix una tasca d'avaluació com una prova amb entrades definides i criteris d'èxit, i un avaluador com la lògica que puntua algun aspecte del resultat. Un criteri d'acceptació amb entrades concretes i un resultat esperat ja és una tasca d'avaluació. El que li falta per ser un eval és l'avaluador: qui o què diu «compleix» o «no compleix».
Quan aquest avaluador no surt del criteri, surt del codi. I un test escrit a partir del codi no el prova, el descriu: confirma el que el codi fa, inclòs el que fa malament. Ho expliquem en detall a tests generats per IA. L'especificació com a eval és l'altra cara d'aquest problema: el criteri existeix abans que el codi i és l'única cosa que el pot jutjar.
La prova dels dos lectors
Com se sap si un criteri es pot puntuar? La guia d'Anthropic dona una vara senzilla per a una bona tasca d'avaluació: dos experts del domini arribarien per separat al mateix veredicte d'aprovat o suspès. I avisa del que passa si no: l'ambigüitat en l'especificació de la tasca es converteix en soroll a les mètriques.
La prova dels dos lectors: si dues persones que coneixen el producte poden llegir un criteri, mirar el resultat i discrepar sobre si es compleix, aquest criteri encara no és un criteri. És una intenció.
La documentació d'Anthropic sobre criteris d'èxit insisteix en el mateix amb altres paraules: específics i mesurables. El seu exemple de criteri dolent és «el model ha de classificar bé»; el bo fixa la mètrica, el llindar i el conjunt de dades amb què es mesura. En un equip de desenvolupament, la traducció és directa. Aquests són exemples inventats per il·lustrar-ho, no d'un projecte real:
| Criteri que no es pot puntuar | El mateix criteri, a punt per ser un eval |
|---|---|
| «L'exportació de factures ha de ser ràpida» | Donat un fitxer de 10.000 factures, quan s'exporta a l'entorn d'integració contínua, aleshores l'exportació acaba en menys de 5 segons |
| «Els errors han de ser clars» | Donada una factura sense NIF, quan s'envia a l'API, aleshores respon 422 i el camp nif apareix a la llista d'errors |
| «Ha de respectar els permisos» | Donat un usuari sense el rol de facturació, quan demana l'exportació, aleshores rep 403 i no es genera cap fitxer |
Exemples il·lustratius, elaboració pròpia d'onext. El format «donat, quan, aleshores» és el GIVEN/WHEN/THEN de BDD
El format de la columna dreta no és casual. Birgitta Böckeler, de Thoughtworks, quan analitza les eines d'SDD, descriu com una d'elles, Kiro, estructura els requisits com a històries d'usuari amb criteris d'acceptació en format GIVEN… WHEN… THEN…. Aquest format obliga a dir l'entrada, l'acció i el resultat, que és just el que necessita un avaluador.
Tres tipus de criteri, tres avaluadors
No tots els criteris es puntuen igual, i forçar-ho tot a un test automàtic és l'error contrari al de no tenir-ne cap. La guia d'Anthropic enumera les virtuts dels avaluadors basats en codi —ràpids, barats, objectius, reproduïbles— i també els seus límits: són fràgils davant de variacions vàlides que no encaixen exactament amb el que s'esperava i els falta matís. Per al que té matís proposa models com a jutges, calibrats sovint amb el judici d'experts humans. Portat a una especificació:
| Tipus de criteri | Qui el puntua | Què fa en el merge |
|---|---|---|
| Determinista | Codi: un test unitari, d'integració o de contracte que surt del criteri | Frena. Si no passa, el canvi no entra |
| Amb matís | Una rúbrica escrita a l'especificació; si la puntua un model, calibrat abans amb persones | Informa. Només frena quan el jutge està calibrat i el llindar acordat |
| De risc o de negoci | Una persona amb nom, fixada a l'especificació | Signa. Sense la seva signatura, no entra |
Elaboració pròpia d'onext, a partir de la classificació d'avaluadors d'Anthropic (codi, model i persona)
La tercera fila és la que més s'oblida. Hi ha criteris que cap avaluador automàtic hauria de decidir: els que toquen diners, dades personals, permisos o una regla de negoci discutible. Aquí l'eval és una persona, i l'especificació ha de dir quina. És la idea que desenvolupem a l'especificació és on se signa: no se signa tot, perquè aprovar-ho tot no és control, és un embús; se signa on hi ha risc.
La segona fila té el seu propi mètode. Una rúbrica sense un conjunt de casos de referència és una opinió amb format de mètrica; com construir aquest conjunt i què vol dir «funciona millor» ho tractem a el golden set i a rúbrica i baseline.
La porta del merge: el que és nou falla primer i l'anterior continua passant
Amb els criteris classificats, la porta del merge es munta amb dues regles, i cap no és nostra.
El que és nou falla primer. El mètode de spec-kit exigeix TDD estricte: no s'escriu codi d'implementació fins que els tests estan escrits, una persona els ha aprovat i s'ha confirmat que fallen. Un test que passa abans que existeixi el codi no està comprovant res. Aplicat a l'especificació com a eval: els tests que surten dels criteris nous s'escriuen abans que el codi —els pot redactar un agent—, una persona els revisa contra el criteri, no contra la implementació, i han de fallar en vermell abans de començar.
L'anterior continua passant. Els criteris de les especificacions ja integrades formen la suite de regressió. La guia d'Anthropic diu que una suite de regressió hauria de fregar el 100 % d'encerts, i que els evals de capacitat que ja se superen amb marge es poden «graduar» a regressió. Segons la mateixa guia, és l'estructura amb què es puntuen els agents de codi a SWE-bench Verified: una solució només passa si arregla els tests que fallaven sense trencar els que ja existien.
Amb això, revisar un pull request canvia de pregunta. Ja no és «em convenç aquest codi?», que amb un agent que produeix més canvis per hora es converteix en el coll d'ampolla, sinó «els criteris de l'especificació estan coberts i en verd, i han signat els que havien de signar?». La revisió humana no desapareix; es concentra on aporta. Ho desenvolupem a la revisió que continua esperant un autor.
El que això no resol
Convé dir els límits amb la mateixa claredat que la tesi. El primer l'assenyala Böckeler: fins i tot amb tots els fitxers, plantilles, fluxos i llistes de comprovació de les eines d'SDD, va veure sovint que l'agent acabava sense seguir totes les instruccions. Una especificació més llarga no garanteix que es compleixi. Precisament per això el control no és a l'extensió de l'especificació, sinó en el fet que cada criteri es comprovi abans d'integrar.
El segon límit és el revers del primer: un eval només aprova el que mesura. El que l'especificació no recull, cap test no ho caçarà, i un tauler en verd pot donar la mateixa falsa sensació de control que Böckeler planteja per a les mateixes eines d'SDD. La prova dels dos lectors ajuda a fer que cada criteri estigui ben escrit; no diu si en falten. Això continua sent feina de qui coneix el producte.
I el tercer és de cost: escriure criteris que es puguin puntuar porta més temps al principi que escriure intencions. No tenim una xifra mesurada de quant, i no la inventarem. El que sí que es pot raonar és on es paga si no es fa: en una revisió que discuteix què volia dir l'especificació quan el codi ja està escrit.
Si vols saber per on comença això al teu equip, tria l'última especificació que vau donar per bona i recorre'n els criteris un per un amb una sola pregunta: qui o què el puntua. Els que tinguin resposta ja són el teu eval. Els que no, són la feina pendent, i solen ser els mateixos que provoquen les discussions més llargues a la revisió. Encaixa en la perspectiva de processos de les quatre perspectives d'un equip de desenvolupament amb IA: el ready és l'especificació i el done, la verificació contra ella. I si el mètode sencer et resulta nou, comença per què és el Spec-Driven Development.
La pregunta per a la teva propera reunió d'equip: quants criteris de la vostra última especificació podria puntuar algú que no la va escriure?
Preguntes freqüents
Què vol dir que una especificació sigui un eval?
Que cada criteri d'acceptació de l'especificació està escrit amb entrades concretes i un resultat que es pot puntuar, de manera que en surt directament la comprovació que decideix si un canvi entra. L'especificació deixa de ser documentació que es llegeix abans de programar i passa a ser el que s'executa abans d'integrar.
Com sé si un criteri d'acceptació és verificable?
Amb la prova dels dos lectors: si dues persones que coneixen el producte poden llegir el criteri, mirar el resultat i arribar per separat a veredictes diferents, el criteri no està acabat. La guia d'evals d'Anthropic fa servir aquesta mateixa vara per a una bona tasca d'avaluació i adverteix que l'ambigüitat en l'especificació es converteix en soroll a les mètriques.
Tots els criteris d'acceptació s'han de convertir en tests automàtics?
No. Els criteris deterministes es comproven amb codi i poden frenar el merge. Els que tenen matís, com la claredat d'un missatge, es puntuen amb una rúbrica i, si s'utilitza un model com a jutge, calibrat amb persones. I els que depenen d'un judici de negoci o tenen risc els signa una persona amb nom. Forçar-ho tot a test produeix tests fràgils que fallen davant de variacions vàlides.
Qui ha d'escriure el test que surt d'un criteri d'acceptació?
El pot escriure un agent, però abans que el codi i a partir del criteri, mai a partir del codi ja generat. Una persona revisa aquest test contra el criteri, no contra la implementació. Un test derivat del codi només descriu el que el codi fa, inclòs el que fa malament.
Quins evals haurien de frenar un merge?
Dos grups. Els criteris nous de l'especificació, que han de fallar abans d'implementar i passar després. I els criteris d'especificacions anteriors, que formen la suite de regressió: segons la guia d'evals d'Anthropic, una suite de regressió hauria de fregar el 100 % d'encerts. És la mateixa estructura amb què SWE-bench Verified dona per bona una solució.
N'hi ha prou d'escriure una especificació més detallada perquè l'agent la compleixi?
No. Birgitta Böckeler, de Thoughtworks, explica que fins i tot amb plantilles, llistes de comprovació i fluxos complets va veure sovint que l'agent acabava sense seguir totes les instruccions. Més especificació no garanteix el compliment; el que dona control és que cada criteri es comprovi abans d'integrar.
Fonts
- Mikaela Grace, Jeremy Hadfield, Rodrigo Olivares i Jiri De Jonghe (Anthropic), «Demystifying evals for AI agents», 9 de gener de 2026.
- Anthropic, documentació de Claude, «Define success criteria and build evaluations».
- GitHub, spec-kit, «Specification-Driven Development (SDD)».
- Birgitta Böckeler (Thoughtworks), «Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl», martinfowler.com, 15 d'octubre de 2025.
Bernat López és fundador i CEO d'onext, boutique d'IA. Acompanya equips de desenvolupament i de producte a treballar amb IA amb mètode —especificació abans de programar, una persona que decideix on hi ha risc i Spec-Driven Development— i aplica a la seva pròpia empresa el que proposa: onext funciona amb el seu propi sistema agèntic.
LinkedIn →