
«¿El asistente va mejor que el mes pasado?» Es lo que pregunta la dirección después de cada cambio de prompt, y la respuesta suele ser «yo diría que sí». Nadie puede decir qué habría tenido que ver en pantalla para contestar que no.
Propongo llamarlo criterio sin escribir: dar por bueno el comportamiento de una IA porque a quien la mira le parece bien, sin haber puesto antes por escrito qué cuenta como un fallo.
Criterio sin escribir: decidir que una IA funciona o ha mejorado por la impresión de quien la mira, sin una lista escrita de lo que cuenta como fallo y de lo que se acepta.
La tesis
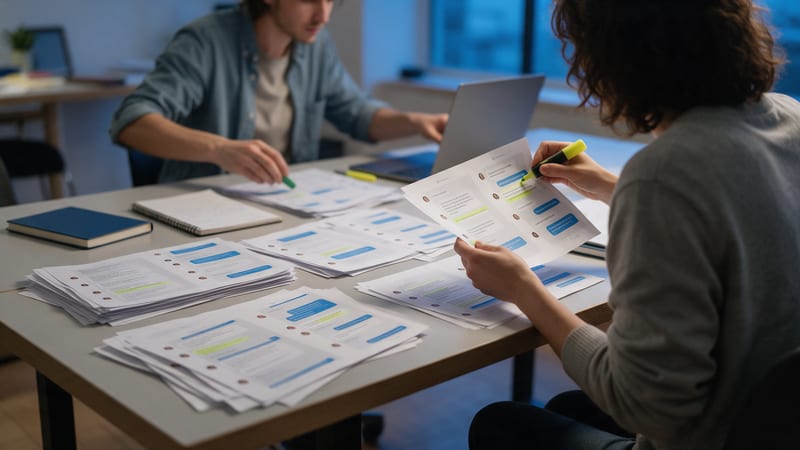
No digo que haya que montar una plataforma de evaluación ni empezar por un cuadro de métricas; digo que lo primero es que dos personas del equipo lean juntas decenas de salidas reales del sistema y escriban qué falla y qué gravedad tiene. La métrica nace de esa lectura, y quien la define es quien conoce el producto. Así un equipo sale del criterio sin escribir.
Una evaluación (en inglés, eval) es una medida repetible de si lo que produce la IA sirve para lo que tu negocio necesita. La parte difícil de una evaluación es el criterio con el que puntúa.
Lo que dicen los datos
Hamel Husain, que ayuda a equipos a evaluar productos con modelos de lenguaje, lo planteó en marzo de 2024: hay que revisar tantos datos reales como se pueda, hasta dejar de aprender cosas nuevas, y escribir pruebas pequeñas y baratas que se ejecuten en cada cambio. Para las valoraciones humanas recomienda empezar con etiquetas simples de bueno o malo, y deja claro que el porcentaje de fallo aceptable es una decisión de producto.
Hay un matiz que complica el consejo fácil de «escribe los criterios y mide». Shreya Shankar y sus colegas describen, en un estudio con usuarios publicado como preprint en abril de 2024, la deriva de criterios: necesitamos criterios para puntuar las salidas, pero puntuarlas nos ayuda a definir los criterios, y algunos solo aparecen al ver lo que el modelo escribe. Es un estudio cualitativo y sin cifras, pero explica por qué los criterios se escriben después de leer y se revisan cada vez que se vuelve a leer.
Anthropic, en su guía de ingeniería sobre evaluar agentes (9 de enero de 2026), propone empezar con entre 20 y 50 tareas sacadas de fallos reales y recuerda que muchos equipos esperan a tener cientos sin necesitarlos. Cuenta también un caso útil: un modelo sacaba un 42 % en un banco de pruebas hasta que un investigador encontró que la corrección era demasiado rígida (rechazaba un 96,12 cuando la respuesta esperada era 96,124991…), que había enunciados ambiguos y que algunas tareas no se podían reproducir. Arreglado eso, la puntuación subió al 95 %. La lección es que la propia medida puede estar mal.
La consistencia también cuenta. El benchmark τ-bench (Yao y colaboradores, junio de 2024) midió agentes con herramientas en conversaciones simuladas de atención al cliente: los agentes más avanzados de entonces, como gpt-4o, resolvían menos del 50 % de las tareas y, al repetir cada una ocho veces, acertaban las ocho en menos del 25 % de las de comercio. Tres ejemplos buenos en una demostración dicen poco de lo que pasará la cuarta vez.
Los jueces automáticos, un modelo que puntúa las respuestas de otro, tienen su propia trampa. Husain advierte, en su guía de octubre de 2024 actualizada en septiembre de 2026, de que el porcentaje de acuerdo con la persona engaña cuando los fallos son raros: un juez que diera siempre «correcto» coincidiría con la persona el 95 % de las veces en un sistema que acierta el 95 % (la cuenta es nuestra). Por eso pide un experto de dominio, decisiones de pasa o no pasa con su crítica escrita y medir por separado cuántos aciertos y cuántos fallos detecta el juez. La documentación de evaluación de OpenAI (sin fecha visible, consultada el 16 de noviembre de 2026) lista entre sus antipatrones las «vibe-based evals», dar algo por bueno porque «parece que funciona», y recomienda ampliar un juez solo cuando coincida de forma consistente con las anotaciones de personas.
Los límites: Husain, Anthropic y OpenAI hablan desde su práctica y su documentación; τ-bench son escenarios simulados con modelos de 2024, y el trabajo de Shankar es cualitativo. Ninguna de estas fuentes es un estudio controlado sobre el asistente de tu empresa.
Qué se ve en las reuniones
- Se cambia el prompt y se prueba con las tres preguntas que todo el mundo recuerda de la última reunión.
- El informe de calidad es la media de las puntuaciones de un modelo juez que nadie ha comparado con la opinión de una persona.
- Dos personas leen la misma respuesta, una la da por buena y otra por mala, y se impone la de más rango.
- Cada queja de un cliente se arregla por separado, y nadie comprueba si el arreglo estropea una respuesta que ya funcionaba.
- Tras cambiar de modelo se dice que «va igual», y nadie sabe qué se ha mirado para decirlo.
Por qué es comprensible
Escribir qué es un fallo obliga a discutir, y discutir con la entrega encima es lo último que apetece. Las demostraciones convencen, y las herramientas ofrecen puntuaciones listas para usar que dan sensación de rigor. Además, durante años el software se ha probado con tests que dicen verde o rojo. Con los modelos de lenguaje esa comodidad se acaba: hay muchas respuestas aceptables y alguien tiene que decidir cuáles.
También pesa el momento. Un equipo que acaba de poner en producción su primer asistente tiene delante trabajo visible y con fecha, y las evaluaciones son trabajo invisible: nadie las nota hasta que faltan. Tiene sentido que pierdan frente a la siguiente funcionalidad.
Parte de la responsabilidad es de la dirección. Si cada revisión premia la mejor demostración y nadie pide ver los veinte peores casos de la semana, el equipo hace lo que se le pide: enseñar lo que luce.
Qué se pierde sin criterio escrito
Sin criterio escrito, cada cambio de prompt es una apuesta: nadie puede decir si mejora el caso que preocupa y empeora otro. El equipo gasta semanas ajustando contra su impresión y se entera de los fallos cuando los notan los clientes. Un juez automático sin validar puntúa bien lo que suena bien, y la métrica acaba confirmando lo que el equipo ya pensaba. Y como el criterio vive en la cabeza de dos o tres personas, se va con ellas cuando cambian de proyecto.
Hay un coste más discreto. Cuando por fin llega la queja grave, el equipo no tiene casos previos con los que reproducirla ni un criterio con el que decidir si es un fallo aislado o un tipo de fallo que lleva meses ahí.
Qué hacer
Si diriges el equipo:
- Nombra a una persona de negocio que decida qué es «bien» en este producto y dale una hora a la semana, durante un mes, para leer salidas reales junto a ingeniería. Teresa Torres, que escribe para equipos de producto, lo plantea así en su guía de septiembre de 2026: la corrección depende del contexto, y no conviene que sea un proveedor quien la defina para tu producto.
- Pide en cada revisión los veinte peores casos reales de la semana, además de los mejores.
- Guarda los criterios y los casos en el repositorio, junto al contexto del equipo (sus reglas y su conocimiento del producto), y haz que se ejecuten solos en cada cambio de prompt, de modelo o de herramientas: ningún cambio entra sin pasarlos. Cuando alguien proponga cambiar de modelo, pide el mismo conjunto de casos ejecutado con el modelo actual y con el nuevo antes de decidir.
- Fija con el equipo, para cada tipo de fallo, el porcentaje que aceptáis y revísalo cada trimestre. Es una decisión de producto.
Si haces el trabajo:
- Haz primero el análisis de errores. Lee entre 50 y 100 salidas reales (cifra orientativa nuestra), anota en una línea qué falla en cada una y agrupa por tipo. Detente cuando veinte lecturas seguidas no traigan ningún tipo nuevo (criterio orientativo nuestro).
- Convierte cada tipo frecuente en una pregunta de sí o no, con un ejemplo que pasa y otro que falla («¿cita un precio que no está en el contexto?»). Usa el juez automático solo para lo que no se pueda comprobar con código.
- Valida el juez automático antes de fiarte: etiqueta a mano un conjunto con una persona que conozca el dominio, mide por separado qué fallos detecta y qué aciertos respeta, dale la salida «no lo sé» y no amplíes su uso hasta que coincida.
- Llévalo al ciclo de desarrollo. El criterio acordado entra como criterio de aceptación de la especificación en Spec-Driven Development (SDD, desarrollo guiado por especificaciones: la especificación, con criterios que se pueden comprobar, se aprueba antes de escribir código), de modo que la especificación ya es un eval, y cada fallo que llega de producción se convierte en un caso nuevo de la regresión. Ejecuta cada caso varias veces para comprobar que el resultado se repite, y vuelve a leer salidas cada vez que cambien los criterios. Para medir si un cambio mejora de verdad hacen falta además una rúbrica y un punto de comparación.
He visto lo difícil que es definir el criterio de qué significa «bueno» o «mejor» en un equipo de pedagogos que revisaba un asistente de formación, o definir la rúbrica para evaluar si una respuesta a una licitación es mejor que la anterior en Licia, el asistente de licitaciones de onext. Por eso hemos implementado LLMOps, un flujo de trabajo para la capa agéntica de nuestros proyectos basado en establecer rúbricas, golden sets (conjuntos de casos de referencia), mutaciones (variantes de cada caso para ver si el resultado aguanta) y evaluaciones.
Escribir qué cuenta como un fallo es lo que saca a un equipo del criterio sin escribir, y lo decide quien conoce el producto.
Preguntas frecuentes
¿Qué es un eval de IA?
Es una medida repetible de si lo que produce la IA sirve para lo que tu negocio necesita. Puede ser una comprobación hecha con código, un juez automático o una persona que puntúa. Lo difícil es decidir con qué criterio puntúa.
¿Qué es el análisis de errores en un sistema con IA?
Es leer salidas reales del sistema, anotar en una línea qué falla en cada una y agrupar los fallos por tipo. De esa lista salen los criterios que merece la pena medir, y también los que no.
¿Cuántos ejemplos hacen falta para empezar?
Menos de los que se suele pensar. La guía de ingeniería de Anthropic de enero de 2026 propone empezar con 20 a 50 tareas sacadas de fallos reales y avisa de que muchos equipos esperan a tener cientos sin necesitarlos.
¿Por qué criterios de sí o no en vez de una escala del 1 al 5?
Hamel Husain recomienda empezar con etiquetas simples de bueno o malo, y en su guía de jueces pide decisiones claras de pasa o no pasa con una crítica escrita. Obligan a decidir y se pueden contrastar con lo que opina una persona.
¿Se puede fiar de un modelo que puntúa a otro?
Solo después de validarlo. Hay que etiquetar a mano un conjunto con una persona que conozca el dominio, medir por separado qué fallos detecta y qué aciertos respeta, y no ampliar su uso hasta que coincida de forma consistente con las personas.
¿Qué es pass^k y por qué importa?
Es la probabilidad de acertar las k veces que se repite una misma tarea. Anthropic da un ejemplo: con un 75 % de acierto por intento, acertar tres veces seguidas ronda el 42 %, porque es 0,75 elevado a 3. Por eso cada caso se ejecuta varias veces.
Fuentes
- Hamel Husain, «Your AI Product Needs Evals», 29 de marzo de 2024.
- Shreya Shankar, J.D. Zamfirescu-Pereira, Björn Hartmann, Aditya G. Parameswaran e Ian Arawjo, «Who Validates the Validators? Aligning LLM-Assisted Evaluation of LLM Outputs with Human Preferences», arXiv 2404.12272, 18 de abril de 2024.
- Hamel Husain, «Using LLM-as-a-Judge For Evaluation: A Complete Guide», 29 de octubre de 2024, actualizada el 1 de septiembre de 2026.
- Anthropic, «Demystifying evals for AI agents», 9 de enero de 2026.
- Shunyu Yao, Noah Shinn, Pedram Razavi y Karthik Narasimhan, «τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains», arXiv 2406.12045, 17 de junio de 2024.
- OpenAI, «Evaluation best practices», documentación para desarrolladores, sin fecha de publicación visible; consultada el 16 de noviembre de 2026.
- Teresa Torres, «AI Evals: A Hands-On Guide for Product Teams», Product Talk, 2 de septiembre de 2026.
Bernat López es fundador y CEO de onext, boutique de IA. Acompaña a equipos de desarrollo y de producto a trabajar con IA con método —especificación antes de programar, controles automáticos y Spec-Driven Development— y aplica a su propia empresa lo que propone: onext funciona con su propio sistema agéntico.
LinkedIn →