
«L'assistent va millor que el mes passat?» És el que pregunta la direcció després de cada canvi de prompt, i la resposta sol ser «jo diria que sí». Ningú no sap dir què hauria hagut de veure a la pantalla per contestar que no.
Proposo anomenar-ho criteri sense escriure: donar per bo el comportament d'una IA perquè a qui la mira li sembla bé, sense haver posat abans per escrit què compta com un error.
Criteri sense escriure: decidir que una IA funciona o ha millorat per la impressió de qui la mira, sense una llista escrita del que compta com un error i del que s'accepta.
La tesi
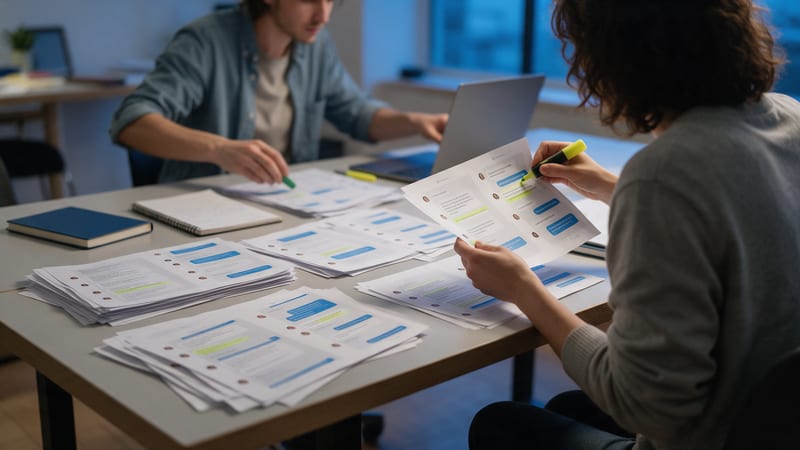
No dic que calgui muntar una plataforma d'avaluació ni començar per un quadre de mètriques; dic que el primer és que dues persones de l'equip llegeixin juntes desenes de sortides reals del sistema i escriguin què falla i quina gravetat té. La mètrica neix d'aquesta lectura, i qui la defineix és qui coneix el producte. Així un equip surt del criteri sense escriure.
Una avaluació (en anglès, eval) és una mesura repetible de si el que produeix la IA serveix per al que el teu negoci necessita. La part difícil d'una avaluació és el criteri amb el qual puntua.
El que diuen les dades
Hamel Husain, que ajuda equips a avaluar productes amb models de llenguatge, ho va plantejar el març del 2024: cal revisar tantes dades reals com es pugui, fins a deixar d'aprendre coses noves, i escriure proves petites i barates que s'executin a cada canvi. Per a les valoracions humanes recomana començar amb etiquetes simples de bo o dolent, i deixa clar que el percentatge d'error acceptable és una decisió de producte.
Hi ha un matís que complica el consell fàcil d'«escriu els criteris i mesura». Shreya Shankar i els seus col·legues descriuen, en un estudi amb usuaris publicat com a preprint l'abril del 2024, la deriva de criteris: necessitem criteris per puntuar les sortides, però puntuar-les ens ajuda a definir els criteris, i alguns només apareixen en veure el que escriu el model. És un estudi qualitatiu i sense xifres, però explica per què els criteris s'escriuen després de llegir i es revisen cada cop que es torna a llegir.
Anthropic, a la seva guia d'enginyeria sobre avaluar agents (9 de gener del 2026), proposa començar amb entre 20 i 50 tasques sorgides d'errors reals i recorda que molts equips esperen a tenir-ne centenars sense necessitar-ho. Explica també un cas útil: un model treia un 42 % en un banc de proves fins que un investigador va trobar que la correcció era massa rígida (rebutjava un 96,12 quan la resposta esperada era 96,124991…), que hi havia enunciats ambigus i que algunes tasques no es podien reproduir. Un cop arreglat, la puntuació va pujar al 95 %. La lliçó és que la mesura mateixa pot estar mal feta.
La consistència també compta. El benchmark τ-bench (Yao i col·laboradors, juny del 2024) va mesurar agents amb eines en converses simulades d'atenció al client: els agents més avançats d'aleshores, com gpt-4o, resolien menys del 50 % de les tasques i, en repetir-ne cada una vuit vegades, les encertaven les vuit en menys del 25 % de les de comerç. Tres exemples bons en una demostració diuen poc del que passarà la quarta vegada.
Els jutges automàtics, un model que puntua les respostes d'un altre, tenen la seva pròpia trampa. Husain adverteix, a la seva guia d'octubre del 2024 actualitzada el setembre del 2026, que el percentatge d'acord amb la persona enganya quan els errors són pocs: un jutge que digués sempre «correcte» coincidiria amb la persona el 95 % de les vegades en un sistema que encerta el 95 % (el càlcul és nostre). Per això demana un expert de domini, decisions de passa o no passa amb la crítica escrita i mesurar per separat quants encerts i quants errors detecta el jutge. La documentació d'avaluació d'OpenAI (sense data visible, consultada el 16 de novembre del 2026) llista entre els seus antipatrons les «vibe-based evals», donar una cosa per bona perquè «sembla que funciona», i recomana ampliar un jutge només quan coincideixi de manera consistent amb les anotacions de persones.
Els límits: Husain, Anthropic i OpenAI parlen des de la seva pràctica i la seva documentació; τ-bench són escenaris simulats amb models del 2024, i el treball de Shankar és qualitatiu. Cap d'aquestes fonts és un estudi controlat sobre l'assistent de la teva empresa.
Què es veu a les reunions
- Es canvia el prompt i es prova amb les tres preguntes que tothom recorda de l'última reunió.
- L'informe de qualitat és la mitjana de les puntuacions d'un model jutge que ningú no ha comparat amb l'opinió d'una persona.
- Dues persones llegeixen la mateixa resposta, una la dona per bona i l'altra per dolenta, i s'imposa la de més rang.
- Cada queixa d'un client s'arregla per separat, i ningú comprova si l'arranjament espatlla una resposta que ja funcionava.
- Després de canviar de model es diu que «va igual», i ningú no sap què s'ha mirat per dir-ho.
Per què és comprensible
Escriure què és un error obliga a discutir, i discutir amb el lliurament a sobre és el que menys convé. Les demostracions convencen, i les eines ofereixen puntuacions a punt d'usar que donen sensació de rigor. A més, durant anys el programari s'ha provat amb tests que diuen verd o vermell. Amb els models de llenguatge aquesta comoditat s'acaba: hi ha moltes respostes acceptables i algú ha de decidir quines.
També pesa el moment. Un equip que acaba de posar en producció el seu primer assistent té al davant feina visible i amb data, i les avaluacions són feina invisible: ningú no les nota fins que falten. Té sentit que perdin davant la funcionalitat següent.
Part de la responsabilitat és de la direcció. Si cada revisió premia la millor demostració i ningú no demana veure els vint pitjors casos de la setmana, l'equip fa el que se li demana: ensenyar el que llueix.
Què es perd sense criteri escrit
Sense criteri escrit, cada canvi de prompt és una aposta: ningú no pot dir si millora el cas que preocupa i empitjora un altre. L'equip gasta setmanes ajustant contra la seva impressió i s'assabenta dels errors quan els noten els clients. Un jutge automàtic sense validar puntua bé el que sona bé, i la mètrica acaba confirmant el que l'equip ja pensava. I com que el criteri viu al cap de dues o tres persones, se'n va amb elles quan canvien de projecte.
Hi ha un cost més discret. Quan per fi arriba la queixa greu, l'equip no té casos previs per reproduir-la ni un criteri per decidir si és un error aïllat o un tipus d'error que fa mesos que hi és.
Què fer
Si dirigeixes l'equip:
- Anomena una persona de negoci que decideixi què és «bé» en aquest producte i dona-li una hora a la setmana, durant un mes, per llegir sortides reals amb enginyeria. Teresa Torres, que escriu per a equips de producte, ho planteja així a la seva guia de setembre del 2026: la correcció depèn del context, i no convé que sigui un proveïdor qui la defineixi per al teu producte.
- Demana a cada revisió els vint pitjors casos reals de la setmana, a més dels millors.
- Guarda els criteris i els casos al repositori, al costat del context de l'equip (les seves regles i el seu coneixement del producte), i fes que s'executin sols a cada canvi de prompt, de model o d'eines: cap canvi no entra sense passar-los. Quan algú proposi canviar de model, demana el mateix conjunt de casos executat amb el model actual i amb el nou abans de decidir.
- Fixa amb l'equip, per a cada tipus d'error, el percentatge que accepteu i revisa'l cada trimestre. És una decisió de producte.
Si fas la feina:
- Fes primer l'anàlisi d'errors. Llegeix entre 50 i 100 sortides reals (xifra orientativa nostra), anota en una línia què falla en cada una i agrupa per tipus. Atura't quan vint lectures seguides no portin cap tipus nou (criteri orientatiu nostre).
- Converteix cada tipus freqüent en una pregunta de sí o no, amb un exemple que passa i un altre que falla («cita un preu que no és al context?»). Fes servir el jutge automàtic només per al que no es pugui comprovar amb codi.
- Valida el jutge automàtic abans de refiar-te'n: etiqueta a mà un conjunt amb una persona que conegui el domini, mesura per separat quins errors detecta i quins encerts respecta, dona-li la sortida «no ho sé» i no n'ampliïs l'ús fins que coincideixi.
- Porta-ho al cicle de desenvolupament. El criteri acordat entra com a criteri d'acceptació de l'especificació en Spec-Driven Development (SDD, desenvolupament guiat per especificacions: l'especificació, amb criteris que es poden comprovar, s'aprova abans d'escriure codi), de manera que l'especificació ja és un eval, i cada error que arriba de producció es converteix en un cas nou de la regressió. Executa cada cas diverses vegades per comprovar que el resultat es repeteix, i torna a llegir sortides cada cop que canviïn els criteris. Per mesurar si un canvi millora de debò calen a més una rúbrica i un punt de comparació.
He vist com és de difícil definir el criteri de què significa «bo» o «millor» en un equip de pedagogs que revisava un assistent de formació, o definir la rúbrica per avaluar si una resposta a una licitació és millor que l'anterior a Licia, l'assistent de licitacions d'onext. Per això hem implementat LLMOps, un flux de treball per a la capa agèntica dels nostres projectes basat en establir rúbriques, golden sets (conjunts de casos de referència), mutacions (variants de cada cas per veure si el resultat aguanta) i avaluacions.
Escriure què compta com un error és el que treu un equip del criteri sense escriure, i ho decideix qui coneix el producte.
Preguntes freqüents
Què és un eval d'IA?
És una mesura repetible de si el que produeix la IA serveix per al que el teu negoci necessita. Pot ser una comprovació feta amb codi, un jutge automàtic o una persona que puntua. El difícil és decidir amb quin criteri puntua.
Què és l'anàlisi d'errors en un sistema amb IA?
És llegir sortides reals del sistema, anotar en una línia què falla en cada una i agrupar els errors per tipus. D'aquesta llista surten els criteris que val la pena mesurar, i també els que no.
Quants exemples calen per començar?
Menys dels que se sol pensar. La guia d'enginyeria d'Anthropic de gener del 2026 proposa començar amb 20 a 50 tasques sorgides d'errors reals i avisa que molts equips esperen a tenir-ne centenars sense necessitar-ho.
Per què criteris de sí o no en lloc d'una escala de l'1 al 5?
Hamel Husain recomana començar amb etiquetes simples de bo o dolent, i a la seva guia de jutges demana decisions clares de passa o no passa amb una crítica escrita. Obliguen a decidir i es poden contrastar amb el que opina una persona.
Es pot refiar d'un model que puntua un altre?
Només després de validar-lo. Cal etiquetar a mà un conjunt amb una persona que conegui el domini, mesurar per separat quins errors detecta i quins encerts respecta, i no ampliar-ne l'ús fins que coincideixi de manera consistent amb les persones.
Què és pass^k i per què importa?
És la probabilitat d'encertar les k vegades que es repeteix una mateixa tasca. Anthropic en dona un exemple: amb un 75 % d'encert per intent, encertar tres vegades seguides ronda el 42 %, perquè és 0,75 elevat a 3. Per això cada cas s'executa diverses vegades.
Fonts
- Hamel Husain, «Your AI Product Needs Evals», 29 de març del 2024.
- Shreya Shankar, J.D. Zamfirescu-Pereira, Björn Hartmann, Aditya G. Parameswaran i Ian Arawjo, «Who Validates the Validators? Aligning LLM-Assisted Evaluation of LLM Outputs with Human Preferences», arXiv 2404.12272, 18 d'abril del 2024.
- Hamel Husain, «Using LLM-as-a-Judge For Evaluation: A Complete Guide», 29 d'octubre del 2024, actualitzada l'1 de setembre del 2026.
- Anthropic, «Demystifying evals for AI agents», 9 de gener del 2026.
- Shunyu Yao, Noah Shinn, Pedram Razavi i Karthik Narasimhan, «τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains», arXiv 2406.12045, 17 de juny del 2024.
- OpenAI, «Evaluation best practices», documentació per a desenvolupadors, sense data de publicació visible; consultada el 16 de novembre del 2026.
- Teresa Torres, «AI Evals: A Hands-On Guide for Product Teams», Product Talk, 2 de setembre del 2026.
Bernat López és fundador i CEO d'onext, boutique d'IA. Acompanya equips de desenvolupament i de producte a treballar amb IA amb mètode —especificació abans de programar, controls automàtics i Spec-Driven Development— i aplica a la seva pròpia empresa el que proposa: onext funciona amb el seu propi sistema agèntic.
LinkedIn →